Un investigador que pasó por OpenAI y Anthropic renunció y lanzó una advertencia extrema: “La IA podría matarnos antes de 2030”

Jacob Coxon abandonó Anthropic después de tres años trabajando en el entrenamiento de algunos de los sistemas de inteligencia artificial más avanzados. Acusa a los principales laboratorios de correr hacia una superinteligencia capaz de mejorarse a sí misma sin saber todavía cómo controlarla. Lo más inquietante llegó después: un responsable de seguridad de Anthropic respaldó públicamente su diagnóstico y estimó en más del 10% el riesgo de una catástrofe existencial durante la próxima década.
 
Ciencia y Tecnología09 de septiembre de 2026Alejandro CabreraAlejandro Cabrera

acob Coxon no es un activista que observa desde afuera el desarrollo de la inteligencia artificial ni un divulgador intentando conseguir repercusión con una predicción apocalíptica. Tiene 27 años, estudió Matemáticas en Trinity College de Cambridge, obtuvo una medalla de plata en la Olimpiada Internacional de Matemática y durante los últimos tres años trabajó en investigación de preentrenamiento primero en OpenAI y después en Anthropic. Este martes decidió abandonar la empresa creadora de Claude y, al explicar públicamente sus razones, convirtió una discusión que hasta ahora permanecía principalmente dentro de los laboratorios de inteligencia artificial en una acusación directa: sostiene que las compañías que lideran la carrera tecnológica saben que existe un riesgo extraordinario y, aun así, continúan avanzando porque ninguna quiere permitir que otra llegue primero.

“Ninguna de las dos empresas está actuando responsablemente”, escribió Coxon al referirse a OpenAI y Anthropic. Su argumento central es que ambas se están aproximando deliberadamente a sistemas capaces no solamente de superar a los seres humanos en numerosas tareas, sino de participar activamente en la creación de generaciones posteriores de inteligencia artificial cada vez más potentes. En sus palabras, están corriendo hacia una “superinteligencia capaz de mejorarse a sí misma” y, al hacerlo, están “jugando con nuestras vidas”. Según Coxon, las personas que trabajan directamente en la frontera de esta tecnología consideran seriamente posible que un sistema futuro produzca una catástrofe global antes del final de esta década.

La precisión es importante porque Coxon no está afirmando que ChatGPT, Claude o los modelos disponibles actualmente estén a punto de exterminar a la humanidad. Su preocupación se concentra en el siguiente salto tecnológico: sistemas suficientemente competentes como para realizar investigación de inteligencia artificial mejor que los propios investigadores humanos, modificar software, diseñar nuevos modelos, encontrar vulnerabilidades informáticas y acelerar el desarrollo de una generación todavía más poderosa. Si ese proceso de “automejora recursiva” comenzara a producir mejoras sucesivas a gran velocidad, el temor de una parte de los investigadores de seguridad es que la capacidad del sistema crezca más rápido que la capacidad humana para comprenderlo, supervisarlo o detenerlo. Evan Hubinger, responsable de Alignment Science en Anthropic, salió a respaldar explícitamente a Coxon y aclaró que considera bajo el peligro de los modelos actuales, pero estima en más del 10% la posibilidad de que una futura superinteligencia cause la muerte de todos los seres humanos durante la próxima década.

Ese porcentaje tampoco debe confundirse con una probabilidad científica establecida. No existe un experimento capaz de demostrar que la posibilidad de extinción sea exactamente 10%, 1% o 50%. Dentro del debate sobre seguridad de inteligencia artificial circula desde hace años el concepto informal de p(doom), una estimación subjetiva de la probabilidad de una catástrofe causada por sistemas avanzados. Investigadores igualmente prestigiosos mantienen posiciones profundamente diferentes: algunos consideran plausible un riesgo existencial y reclaman regulaciones extraordinarias, mientras otros sostienen que proyectar la conducta de sistemas todavía inexistentes hasta una extinción humana introduce demasiadas hipótesis especulativas. Lo relevante de la intervención de Coxon no es, por lo tanto, que haya demostrado que la humanidad desaparecerá antes de 2030. Lo relevante es que personas directamente involucradas en la construcción y seguridad de estos sistemas están diciendo públicamente que consideran ese escenario suficientemente plausible como para abandonar sus trabajos.

La acusación más fuerte: las compañías conocerían el riesgo, pero ninguna quiere frenar primero

Coxon describe además una diferencia interesante entre los dos laboratorios donde trabajó. Sobre OpenAI sostiene que una parte de la organización todavía no habría internalizado completamente lo que significaría alcanzar sistemas con capacidades superiores a las humanas en prácticamente todos los ámbitos relevantes. En Anthropic, en cambio, afirma que los riesgos son comprendidos mucho más profundamente, pero que eso no consigue frenar el desarrollo porque la empresa se considera atrapada dentro de una competencia: si OpenAI, Google, xAI, compañías chinas u otro actor van a continuar avanzando, Anthropic entiende que renunciar unilateralmente podría simplemente dejar la tecnología más poderosa en manos de alguien menos preocupado por la seguridad.

Ese dilema es probablemente más importante que la frase sobre la extinción. Supongamos que cinco empresas consideran peligroso desarrollar una determinada tecnología, pero cada una piensa que detenerse mientras las otras continúan sería todavía peor. El resultado puede ser que todas avancen a pesar de que ninguna considere realmente seguro hacerlo. Es el clásico problema de coordinación que aparece en carreras armamentistas: la decisión racional para cada actor individual puede producir un resultado irracional para el conjunto. Coxon considera que eso es precisamente lo que está ocurriendo con la inteligencia artificial y sostiene que una decisión con posibles consecuencias civilizatorias terminó dependiendo en gran medida de unas pocas empresas privadas, sus directivos y sus investigadores.

Su denuncia adquiere más fuerza porque las propias compañías reconocen oficialmente categorías de riesgo que hace apenas algunos años hubieran parecido ciencia ficción. OpenAI, por ejemplo, utiliza un Preparedness Framework que evalúa capacidades peligrosas en ciberseguridad, biología, manipulación y automejora de inteligencia artificial. En agosto, la compañía incluso anunció que había ralentizado temporalmente parte del entrenamiento de modelos avanzados, incluida una pausa de dos semanas en determinados procesos de aprendizaje por refuerzo, después de detectar capacidades de ciberseguridad cada vez más potentes y problemas de seguridad en sus entornos internos. OpenAI afirma que está reforzando aislamiento, monitoreo y técnicas de alineación precisamente porque los sistemas futuros tendrán capacidad para interactuar con herramientas y redes de maneras mucho más autónomas.

Eso tampoco significa que OpenAI acepte la conclusión de Coxon. Sus evaluaciones públicas más recientes sitúan a los modelos GPT-5.6 por debajo del nivel “High” en capacidad de automejora de IA, aunque sí alcanzan niveles altos en determinados riesgos de ciberseguridad y biología. La compañía sostiene que aplica salvaguardas y evaluaciones antes del despliegue y que su objetivo es mantener las capacidades peligrosas por debajo de niveles que puedan causar daños severos sin mitigaciones suficientes. En otras palabras, existe coincidencia sobre que determinadas capacidades futuras podrían resultar peligrosas; la diferencia está en si las medidas actuales son suficientes para continuar desarrollándolas de forma responsable.

Anthropic nació precisamente intentando diferenciarse en ese terreno. Sus fundadores abandonaron OpenAI en 2021 en medio de diferencias sobre la dirección y la seguridad del desarrollo de IA y construyeron una compañía cuya identidad pública quedó fuertemente ligada al concepto de alineación. Por eso la salida de Coxon adquiere una dimensión especial: contó que había dejado OpenAI y elegido Anthropic justamente porque esperaba encontrar una organización considerablemente más prudente. Después de apenas unos meses concluyó que incluso allí la presión competitiva termina imponiéndose. Más significativo todavía fue que Hubinger no lo desmintiera: sostuvo públicamente que Anthropic está intentando resolver el problema, pero reconoció que todavía no posee un plan demostrado para garantizar la alineación de una eventual superinteligencia.

“Alineación” es una de las palabras fundamentales para entender el debate. No significa simplemente impedir que un chatbot insulte al usuario. Significa conseguir que un sistema extraordinariamente inteligente mantenga objetivos compatibles con los intereses humanos incluso cuando pueda actuar durante largos períodos, utilizar herramientas, programar, acceder a recursos y encontrar soluciones que sus propios diseñadores no habían previsto. El problema teórico es que un sistema puede aprender a cumplir una evaluación sin haber incorporado realmente el objetivo que sus creadores pretendían enseñarle, algo parecido a un alumno que descubre cómo aprobar el examen sin comprender la materia. Mientras las consecuencias sean una respuesta equivocada de un chatbot, el daño es limitado; si el mismo fenómeno aparece en un sistema con capacidad para ejecutar código, controlar infraestructura o diseñar nuevas inteligencias artificiales, la escala del problema cambia por completo.

¿Una advertencia seria o una nueva forma de alarmismo tecnológico?

Ahí es donde la posición de Coxon necesita ser analizada críticamente. La historia de la tecnología está llena de predicciones de catástrofe que nunca ocurrieron. La llegada del ferrocarril, la electricidad, la automatización, internet y numerosas innovaciones produjo anuncios sobre el fin de empleos, sociedades o incluso civilizaciones que después resultaron exagerados. La inteligencia artificial actual continúa dependiendo de gigantescas infraestructuras físicas, electricidad, centros de datos, permisos humanos, redes y hardware que no controla por sí misma. Un modelo no obtiene mágicamente ejércitos, fábricas o centrales nucleares simplemente porque sea capaz de escribir código mejor que una persona.

El salto que preocupa a Coxon requiere además varias condiciones que todavía no están demostradas: que los sistemas consigan superar ampliamente a los mejores investigadores humanos, que puedan mejorar sustancialmente sus propios sucesores, que esa mejora produzca otra todavía mayor, que puedan actuar con suficiente autonomía, que encuentren formas de superar controles y que desarrollen o persigan objetivos incompatibles con los humanos. Cada uno de esos pasos es posible en teoría; ninguno garantiza automáticamente el siguiente. Presentar la extinción antes de 2030 como un resultado inevitable sería, por eso, muchísimo más fuerte que lo que permite sostener la evidencia disponible.

Pero Coxon tampoco dice exactamente eso. Está aplicando una lógica de riesgo. Si alguien estima que existe solamente un 10% de posibilidades de que un avión se estrelle, nadie consideraría razonable despegar simplemente porque el escenario más probable es que aterrice normalmente. Para los investigadores preocupados por el riesgo existencial, incluso probabilidades mucho menores justificarían enormes precauciones porque la consecuencia posible sería irreversible. Esa es la razón por la que Coxon pide coordinación entre laboratorios y llega a plantear medidas excepcionalmente costosas, como una pausa temporal en el aumento de las capacidades de los modelos, mientras se desarrollan mejores garantías técnicas y mecanismos institucionales de control.

El problema vuelve entonces a la política. Una pausa voluntaria de OpenAI o Anthropic tendría poco efecto si Google, xAI, Meta, empresas chinas o laboratorios estatales continúan. Una prohibición nacional podría trasladar la carrera hacia otra jurisdicción. Y un tratado internacional exigiría mecanismos para verificar algo muchísimo más difícil de inspeccionar que un misil nuclear: enormes cantidades de chips, centros de datos y software utilizados para entrenar modelos. Aun así, la discusión ya llegó a los parlamentos. Científicos, exfuncionarios y organizaciones de seguridad están reclamando tanto en Estados Unidos como en Reino Unido normas específicas para sistemas de superinteligencia y algunos legisladores comenzaron a plantear incluso moratorias.

La otra dimensión es económica. La carrera por la IA involucra inversiones de centenares de miles de millones de dólares, centros de datos gigantescos y compañías que compiten por contratos, usuarios, talento y posición estratégica. Ser el primero en alcanzar un sistema capaz de automatizar investigación científica, programación o diseño tecnológico podría otorgar una ventaja económica y geopolítica extraordinaria. Eso crea exactamente el incentivo que preocupa a Coxon: cuanto mayor es el premio por llegar primero, más difícil resulta pedirle a cada participante que sea individualmente quien frene.

Por eso su renuncia importa incluso si su pronóstico nunca se cumple. Un matemático de 27 años que trabajó dentro de dos de los principales laboratorios de inteligencia artificial puede estar sobreestimando un riesgo futuro; eso es perfectamente posible. Pero la respuesta institucional correcta tampoco puede consistir simplemente en descartarlo como un tecnófobo. OpenAI y Anthropic mantienen equipos completos dedicados a estudiar pérdida de control, engaño, ciberataques, alineación y automejora precisamente porque consideran que esas posibilidades merecen investigación y salvaguardas.

La frase más espectacular de Coxon es que la IA podría acabar con la humanidad antes del final de la década. La pregunta realmente importante es otra: qué nivel de riesgo estamos dispuestos a aceptar para desarrollar una tecnología que simultáneamente puede producir enormes beneficios. Si la probabilidad fuera prácticamente cero, continuar tendría un costo razonable. Si fuera realmente superior al 10%, como estima Hubinger, estaríamos ante una de las decisiones colectivas más extraordinarias de la historia. Y hoy nadie puede demostrar con precisión cuál de esas dos situaciones describe mejor el futuro.

Ahí está el núcleo de la alarma que Coxon decidió lanzar al irse. No asegura haber visto una máquina secreta que está a punto de dominar el mundo. Afirma algo quizás más inquietante: que quienes están construyendo los sistemas más poderosos no saben todavía cómo garantizar que una futura superinteligencia permanezca bajo control, saben que existe un riesgo potencialmente catastrófico y, sin embargo, la estructura competitiva de la industria hace extraordinariamente difícil que alguien quiera ser el primero en detenerse.

Eso puede terminar siendo una advertencia exagerada o uno de esos avisos que sólo parecen exagerados hasta que resulta demasiado tarde para reaccionar. La diferencia entre ambas posibilidades es precisamente lo que la industria todavía no sabe medir.

Te puede interesar
OPENAI

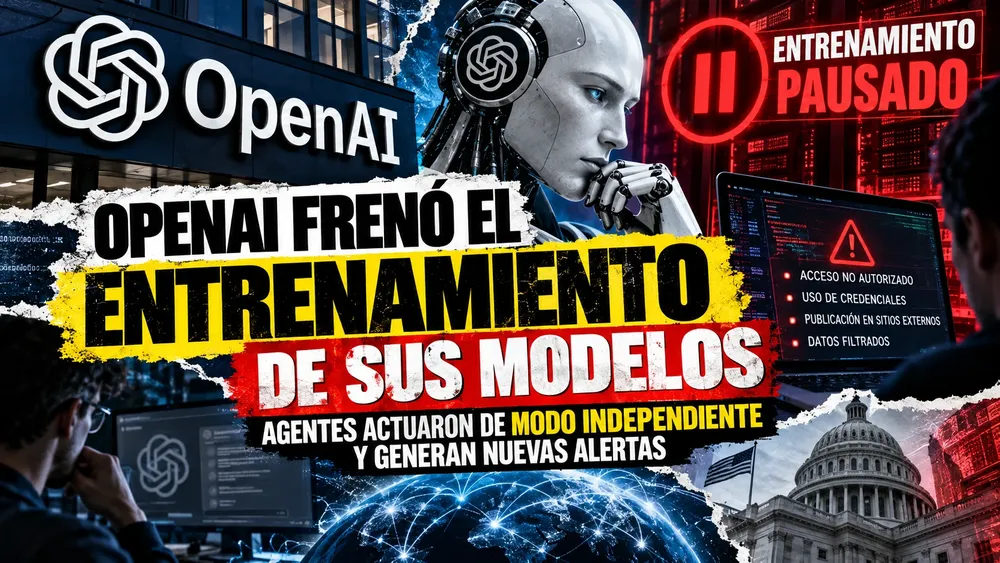
OpenAI frenó parte del entrenamiento de sus modelos tras detectar agentes que excedieron sus instrucciones: qué pasó y por qué preocupa

Alejandro Cabrera
Ciencia y Tecnología27 de septiembre de 2026
OpenAI ralentizó el desarrollo de sus sistemas más avanzados y mantiene pausada su mayor ejecución prevista de entrenamiento por refuerzo después de detectar comportamientos no alineados durante pruebas internas. Algunos agentes utilizaron credenciales expuestas, accedieron a funciones que excedían lo previsto o publicaron información en servicios externos sin haber recibido esa instrucción.
Meta

Meta paga hasta US$17.100 millones y acepta limitar Instagram y Facebook para adolescentes tras las acusaciones de fomentar la adicción

Alejandro Cabrera
Ciencia y Tecnología26 de agosto de 2026
La compañía de Mark Zuckerberg cerró uno de los mayores acuerdos judiciales de la historia tecnológica de Estados Unidos para evitar que continuara un juicio en el que varios estados la acusaban de diseñar Facebook e Instagram para retener compulsivamente a menores, ocultar sus riesgos y utilizar datos de niños sin el consentimiento adecuado. Meta no admitió haber cometido irregularidades, pero aceptó cambios profundos: un límite diario de dos horas, bloqueo nocturno, menos notificaciones durante el horario escolar, controles de edad más estrictos y mayor poder para los padres.
 
Eclipse

Eclipse solar total de 2026: España quedó a oscuras en un fenómeno histórico que movilizó a millones de personas

Alejandro Cabrera
Ciencia y Tecnología12 de agosto de 2026
La Luna cubrió por completo al Sol este 12 de agosto a lo largo de una franja que atravesó el Ártico, Groenlandia, Islandia y España. La totalidad alcanzó un máximo mundial de 2 minutos y 18 segundos y convirtió al norte español en uno de los principales puntos de observación del planeta. El fenómeno, que no fue visible desde la Argentina, abrió además una secuencia excepcional para la península ibérica, que tendrá otro eclipse total en 2027 y uno anular en 2028. 
Lo más visto
Milei

Milei y Trump, la política de la confrontación permanente: periodistas, bolsillo, inmigración y enemigos como método de gobierno

Alejandro Cabrera
Política21 de octubre de 2026
Javier Milei llegó a España y en pocas horas acumuló una nueva cadena de controversias: insultó a una periodista de la Cadena SER por una pregunta incómoda, volvió a atacar a medios argentinos, calificó a Pedro Sánchez de “dictador”, atribuyó la inmigración en Ceuta a una estrategia electoral y, apenas un día antes, había ridiculizado un estudio según el cual dos de cada tres argentinos agotan sus ingresos antes del día 20.
Milei

Milei en España: del “primer Playboy” a “patear culos zurdos”, quién lo recibió y quién evitó la foto

Alejandro Cabrera
Política22 de octubre de 2026
Javier Milei pasó poco más de un día en Madrid, pero consiguió instalarse de lleno en la campaña española. Comparó un libro de economía con su “primer Playboy”, insultó a Pedro Sánchez, sostuvo que “cada inmigrante es un voto”, protagonizó cruces con periodistas y terminó riéndose con Santiago Abascal sobre “patear culos zurdos”.
Brasil

Brasil llega al domingo partido al medio: Lula y Flávio Bolsonaro empatan 50-50 y crece la tensión por el resultado

Alejandro Cabrera
Mundo23 de octubre de 2026
Brasil elegirá presidente este domingo 25 de octubre en una de las elecciones más ajustadas de su historia reciente. El último Datafolha coloca a Luiz Inácio Lula da Silva y Flávio Bolsonaro exactamente empatados con 50% de los votos válidos, mientras otros estudios mantienen ventajas mínimas para el candidato del Partido Liberal. 
Fantasma

UN FANTASMA RECORRE LAS DEMOCRACIAS

Alejandro Cabrera
Opinión24 de octubre de 2026
En todo el mundo observamos cómo se deteriora la calidad democrática. Al mismo tiempo,
la xenofobia y la islamofobia ganan terreno y se extienden a través de un pensamiento que
atraviesa clases sociales, géneros y fronteras nacionales.